Sistemas críticos
Caídas épicas de la nube: el top de los últimos años y cada cuánto falla lo que usa tu empresa
De CrowdStrike a AWS, Cloudflare y la caída de Outlook de esta semana (más de 26 horas): el top 10 con sus informes oficiales y 1.400 incidentes de 30 herramientas que usan las pymes.
- Fecha
- 13 nov 2026
- Lectura
- 12 min
- Resultado
- 10 grandes caídas: 8 de 9 empezaron con un cambio propio y ninguna fue un ataque • 1.400 incidentes de 30 servicios: mediana de 1,46 h y el 76,1 % resueltos en menos de 4 h • una pila de 8 herramientas: unos 8,7 días al mes con alguna incidencia grave
Esta semana se ha caído Outlook. Microsoft 365 empezó a fallar el jueves 12 de noviembre hacia las 13:00 de Nueva York (las 19:00 en España), con un pico de unos 130.000 avisos en Downdetector solo para Outlook. Más de 26 horas después, el viernes a las 21:02 en España, Microsoft seguía sin darla por resuelta: el acceso al correo mejoraba, pero aún estaba vaciando las colas de mensajes y no daba hora para la recuperación completa. Ya es la tercera más larga de nuestro top. No es la primera ni será la última. Hemos reunido las diez caídas más sonadas desde 2021 con sus informes oficiales y el patrón es claro: ninguna fue un ataque. Ocho de las nueve con causa confirmada empezaron con un cambio que hizo la propia empresa, y en seis había además un fallo escondido esperando a que alguien lo activara.
Y como a una pyme lo que le importa no es CrowdStrike sino sus herramientas, hemos medido otra cosa: 1.400 incidentes publicados por 30 servicios que usan las pymes (de Wix a HubSpot, Zoom, Notion o OpenAI). Con ocho herramientas en la nube, casi todos los días alguna avisa de algo, y unos 9 días al mes, de algo grave.
La pregunta
¿Qué provoca las grandes caídas, cuánto duran de verdad y cada cuánto falla lo que usa a diario una empresa normal? Y la que importa: ¿qué debería tener preparado una pyme para el día que se le cae el correo?
Montaje
- Top de caídas: diez incidentes de 2021 a 2026 de alcance mundial o nacional. Para cada uno, las horas de inicio y fin y la causa salen de su informe oficial (post-mortem): AWS, Cloudflare, Google Cloud, Microsoft Azure, Fastly, CrowdStrike, Atlassian, Meta y el informe encargado por el regulador canadiense para Rogers. Facebook no publicó horas: usamos las que midió Cloudflare desde fuera. La caída de Microsoft 365 sigue abierta: usamos su página de estado oficial hasta la actualización del viernes 13 de noviembre a las 20:02 UTC. La clasificación del disparador es nuestra, a partir del texto de cada informe.
- Páginas de estado: la API pública de las páginas de estado (Statuspage) de 31 servicios, consultada el 13 de noviembre de 2026. Cada una devuelve sus últimos 50 incidentes (25 en algunas), así que la ventana que cubre cada servicio es distinta: desde 18 días (Cloudflare, que publica muchísimo) hasta más de 7 años (Shopify). ClickUp quedó fuera porque devuelve incidentes con la fecha de resolución anterior a la de creación. Se descartan los mantenimientos programados.
- Qué medimos de cada servicio: incidentes por cada 30 días, duración mediana, porcentaje de días con algún incidente abierto y porcentaje de días con alguno marcado por la propia empresa como grave («major» o «critical»).
El código y los datos están en nuestro repositorio de GitHub.
El top 10 de caídas épicas
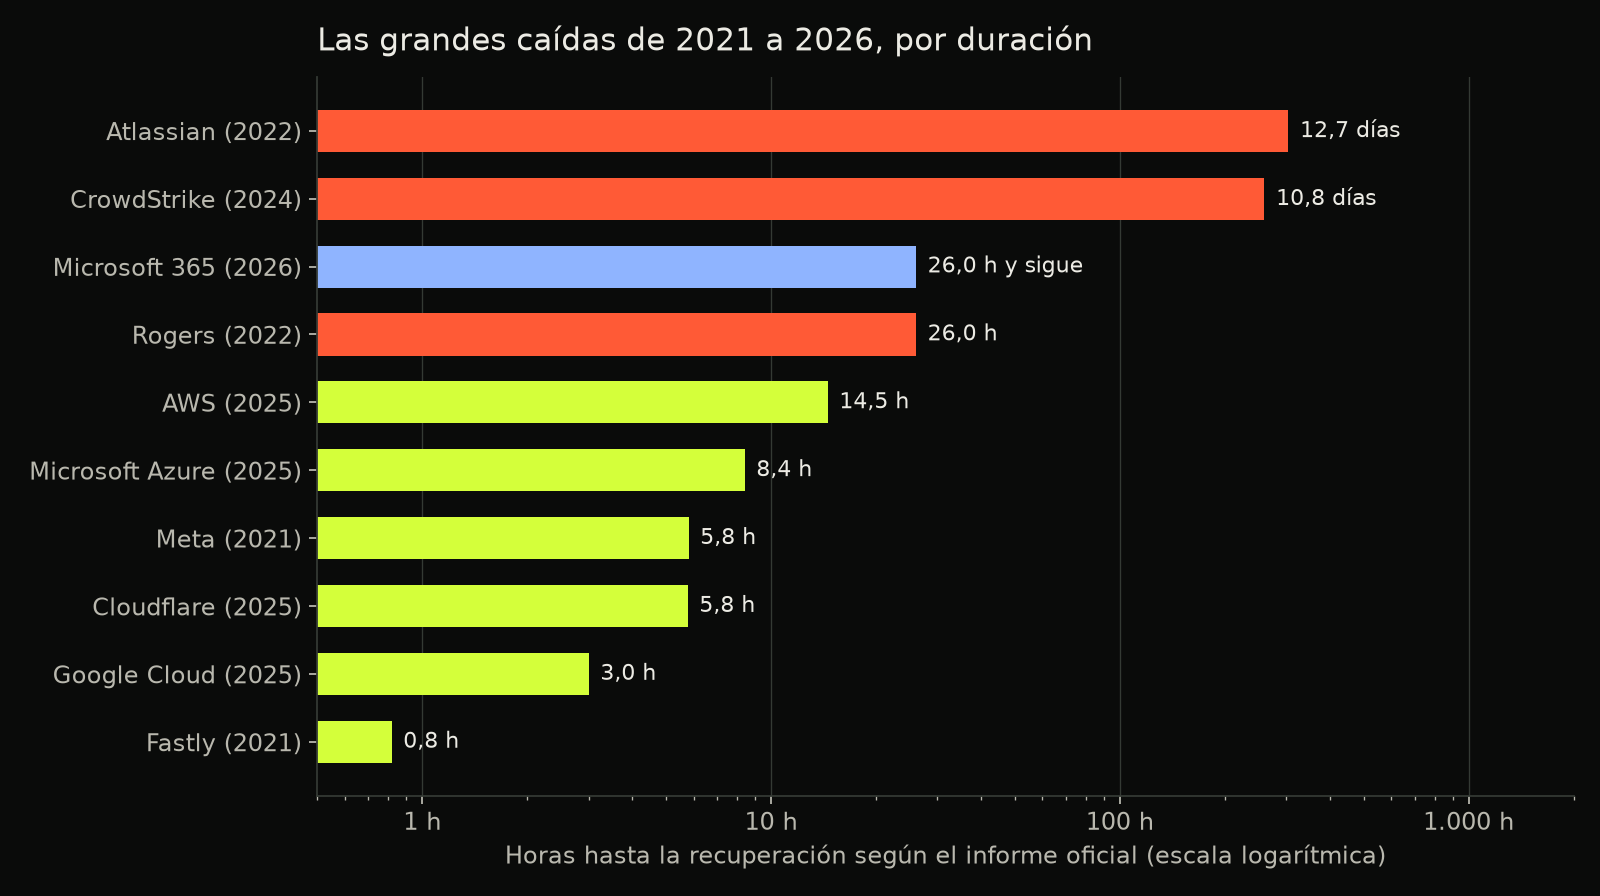
| # | Caída | Duración | Alcance | Qué la disparó |
|---|---|---|---|---|
| 1 | Atlassian (abril de 2022) | 12,7 días | 775 clientes (883 webs) sin Jira ni Confluence | Un script para retirar una aplicación antigua borró webs de clientes enteras |
| 2 | CrowdStrike (julio de 2024) | 10,8 días | 8,5 millones de equipos Windows con pantalla azul | Una actualización del antivirus con un error lógico |
| 3 | Microsoft 365 (noviembre de 2026) | 26,0 h y sigue | Outlook, Exchange, Teams, SharePoint y Copilot; usuarios de 74 países | Sin confirmar: una pérdida de capacidad en el proceso que establece conexiones seguras |
| 4 | Rogers (julio de 2022) | 26,0 h | Más de 12 millones de clientes sin móvil ni internet en Canadá | Un error de configuración en los routers durante una actualización por fases |
| 5 | AWS (octubre de 2025) | 14,5 h | Miles de aplicaciones de la región us-east-1 | Una condición de carrera en la automatización del DNS de DynamoDB |
| 6 | Microsoft Azure (octubre de 2025) | 8,4 h | Webs que usan Azure Front Door, también de Microsoft | Cambios de configuración válidos que activaron un fallo latente |
| 7 | Meta (octubre de 2021) | 5,8 h | Facebook, Instagram, WhatsApp y Messenger en todo el mundo | Un comando de mantenimiento desconectó su red troncal |
| 8 | Cloudflare (noviembre de 2025) | 5,8 h | Miles de webs y aplicaciones | Un cambio de permisos duplicó un fichero de configuración que tumbó el software |
| 9 | Google Cloud (junio de 2025) | 3,0 h | 76 productos de Google Cloud y 10 de Workspace | Un cambio de política con campos vacíos activó un fallo latente |
| 10 | Fastly (junio de 2021) | 0,8 h | El 85 % de su red devolvía errores | La configuración válida de un cliente activó un fallo latente |
Cómo leer las duraciones: son las horas hasta la recuperación que da cada informe. En CrowdStrike la actualización defectuosa solo estuvo publicada 78 minutos, pero hasta que el 99 % de los equipos volvió a conectarse pasaron 10,8 días, porque muchos había que arreglarlos a mano, uno por uno. En Atlassian, los primeros clientes recuperaron el servicio a los tres días y los últimos el 18 de abril (contamos hasta el inicio de ese día; la empresa habla de «hasta 14 días»). En AWS, el incidente principal duró 14,5 horas, pero Redshift no terminó de recuperarse hasta 28,3 horas después del inicio. En Cloudflare, el tráfico principal volvía a fluir a las 3,2 horas. Y en Microsoft 365 contamos desde que se dispararon los avisos de usuarios; el incidente oficial pudo abrirse antes, así que sus 26 horas son un mínimo.
Hemos ordenado por duración porque es la única cifra que todos los informes dan igual; el alcance (clientes, equipos, productos) no se puede comparar entre empresas.
Qué las provoca: el enemigo es el cambio, no el ataque
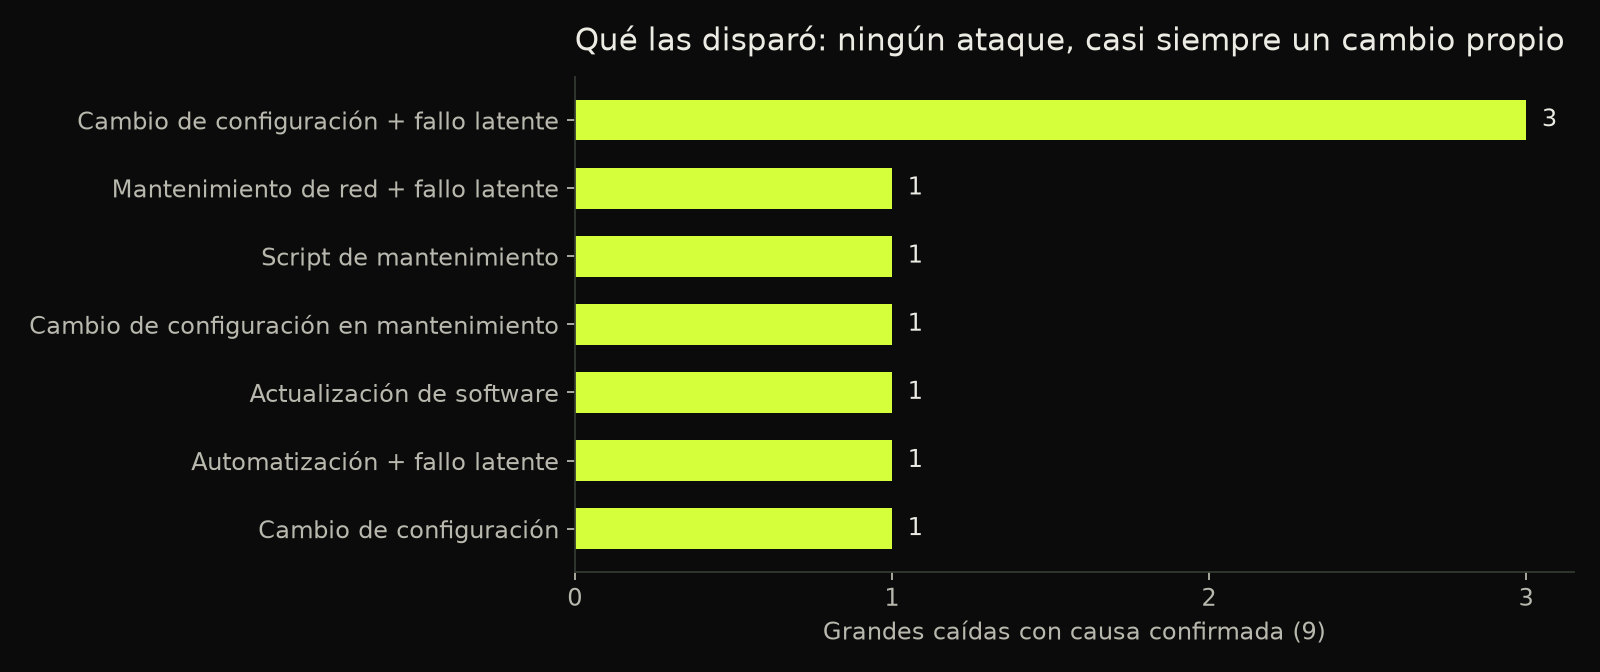
- Ninguna de las nueve con causa confirmada fue un ciberataque. Tampoco la de Microsoft de esta semana: la compañía lo ha descartado públicamente.
- Ocho de nueve empezaron con un cambio propio: una configuración nueva, un mantenimiento, un script o una actualización. La novena (AWS) empezó en la automatización que aplica cambios de DNS por su cuenta.
- En seis de nueve había un fallo latente: un error en el software que llevaba tiempo ahí, sin dar problemas, hasta que un cambio normal lo despertó. En Cloudflare, Google y Azure el cambio era correcto; lo que falló fue cómo el sistema lo procesó.
- El cambio se propagó a todo el mundo antes de que nadie lo parase. Es el denominador común: en Azure, la configuración pasó las comprobaciones porque el fallo tardaba en aparecer; en Cloudflare, el fichero se distribuía cada pocos minutos a toda la red.
La lección para cualquier empresa, también la tuya, es la misma que sacan los informes: los cambios se despliegan poco a poco, con una forma rápida de volver atrás. Es la misma idea de las capas de respaldo que analizamos en el accidente de Urda: el problema nunca es un solo fallo, sino que no haya una segunda barrera.
Lo que sabemos de la caída de Microsoft
- Qué falla: según Microsoft, un proceso de sus servidores de correo que establece las conexiones seguras se satura, y los servidores dejan de atender peticiones. Habla de una pérdida de capacidad, no de un aumento de tráfico.
- Qué intentó: paró todos los despliegues, reinició servidores, los devolvió al servicio con otra forma de comprobar su salud (volvían a colgarse al recibir tráfico), revirtió un cambio de red reciente que coincidía con el inicio (después dijo no haber encontrado un cambio que lo explicase), limitó el tráfico y añadió máquinas.
- Qué no se ha perdido: el correo llega con retraso; Microsoft pide no reenviar los mensajes.
- Qué falta: la causa. Microsoft ha prometido un informe; cuando lo publique, lo incorporaremos a este experimento.
Lo que usa una pyme: cada cuánto falla y cuánto tarda
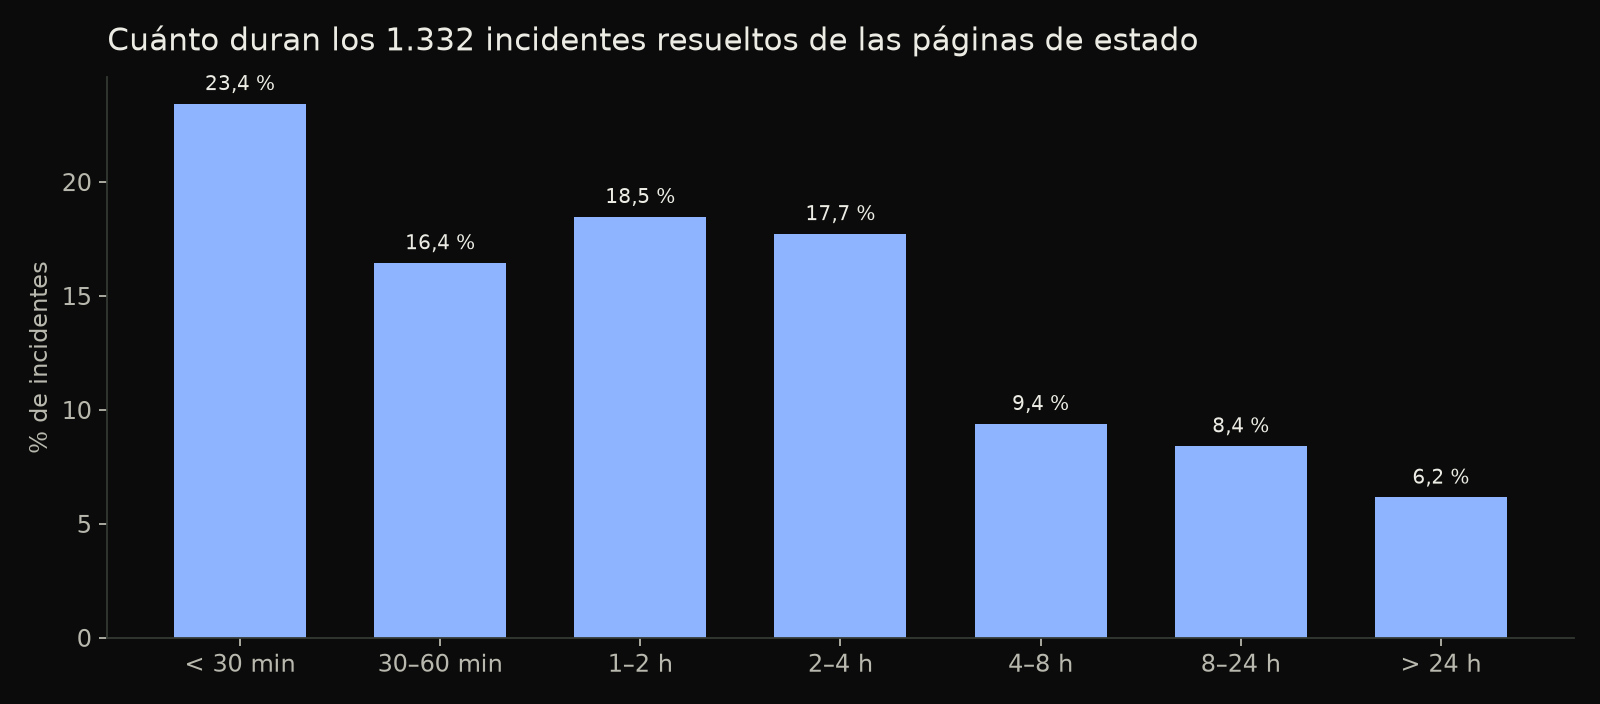
Las grandes caídas son raras. Lo que una pyme vive de verdad son los pequeños fallos de sus herramientas. Medidos en 30 servicios:
- Duración mediana de un incidente: 1,46 horas. El 39,9 % se resolvió en menos de una hora, el 76,1 % en menos de cuatro y solo el 6,2 % duró más de un día.
- La mediana de los servicios tiene algún incidente abierto el 19,1 % de los días, y alguno marcado como grave el 5,1 %.
- El 31,8 % de los incidentes los marcó la propia empresa como graves.
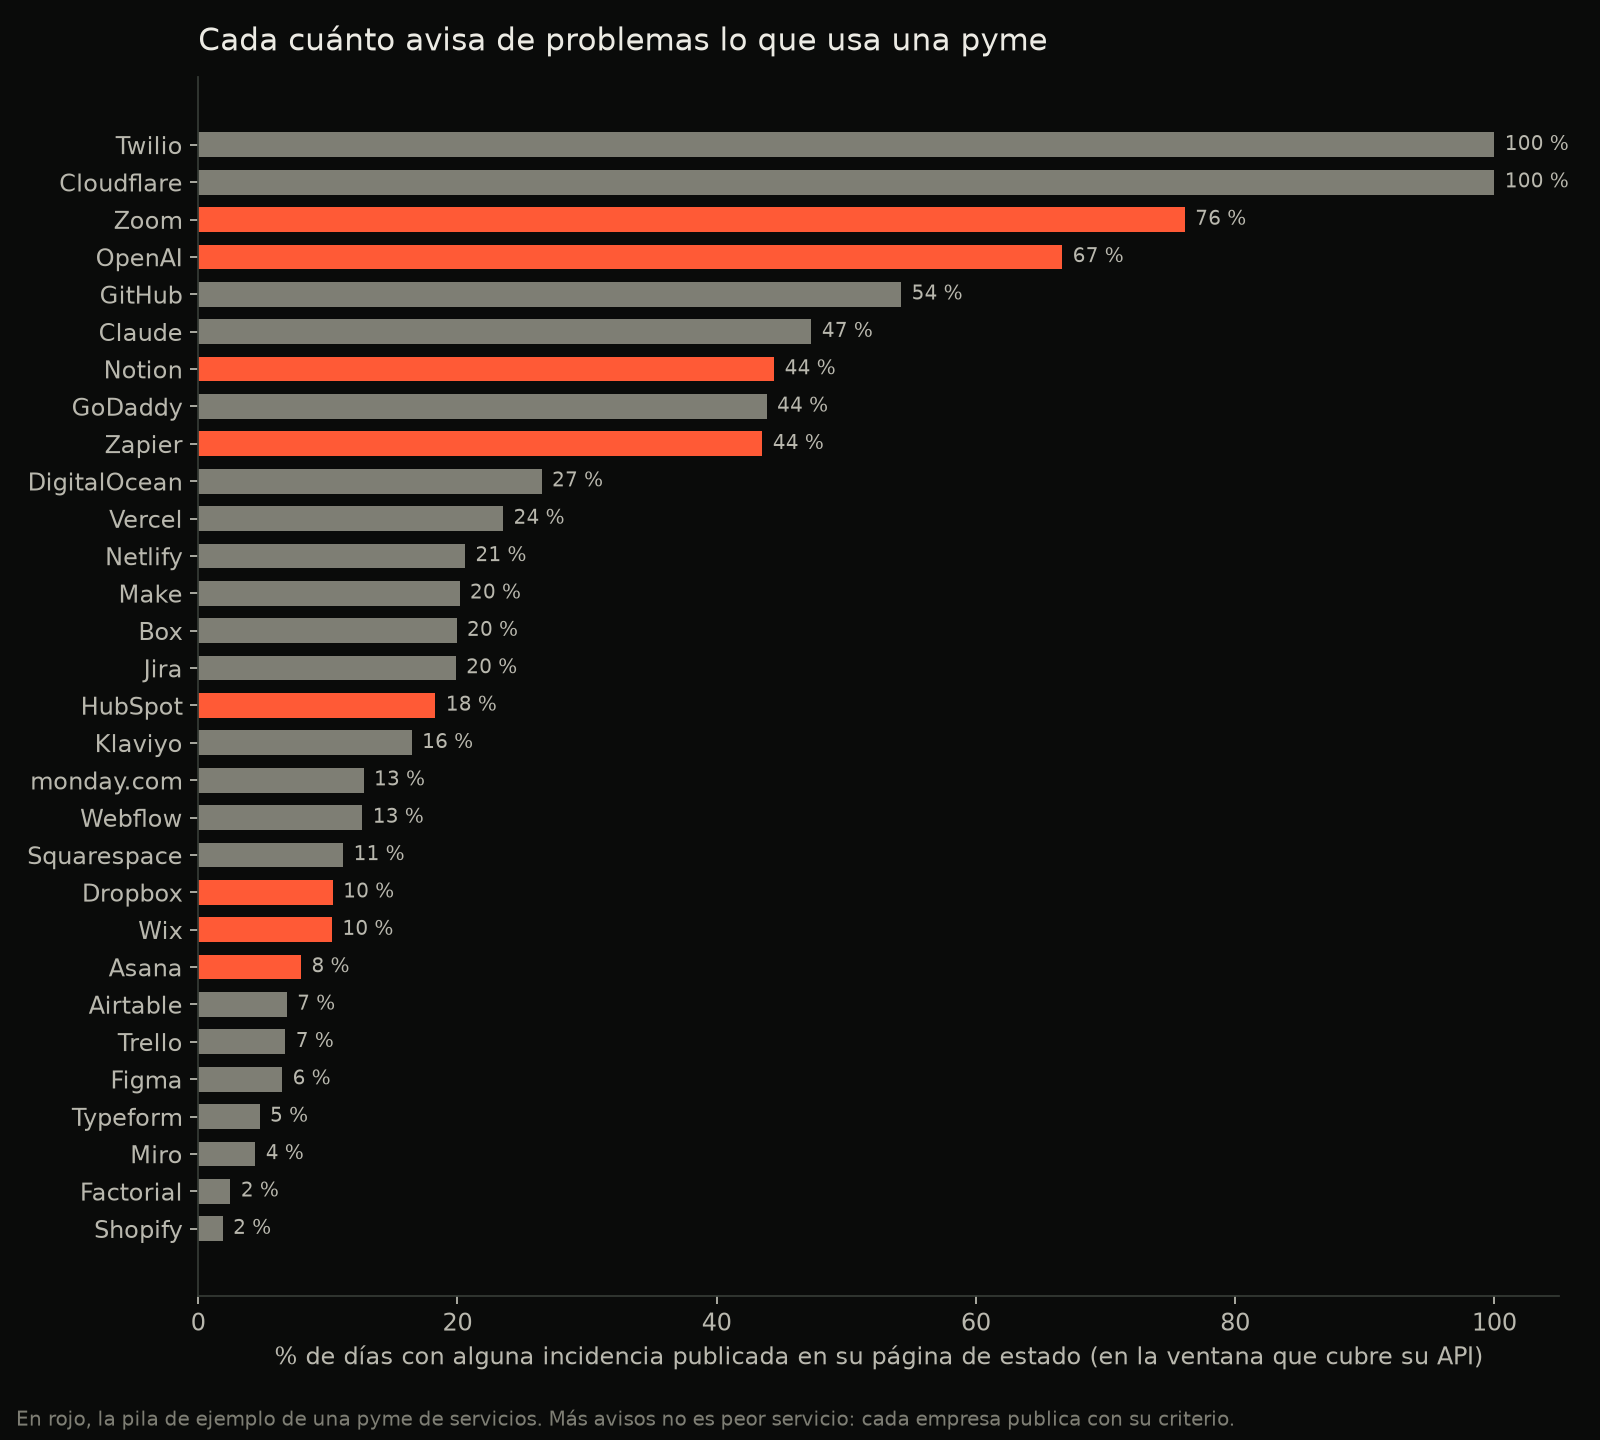
Ojo al leer este gráfico: más avisos no significa peor servicio. Cloudflare y Twilio publican cada incidencia de un centro de datos o de un operador de un país concreto, así que tienen algo abierto casi siempre. Otras empresas solo publican lo que afecta a muchos clientes. Lo que sí dice el gráfico es cuánto se comunica.
Una pyme con ocho herramientas
Hemos tomado una pila de ejemplo de una pyme de servicios: web en Wix, CRM en HubSpot, reuniones en Zoom, archivos en Dropbox, documentación en Notion, tareas en Asana, automatizaciones en Zapier e IA con OpenAI. Si sus fallos fueran independientes:
- 29,5 días de cada 30, alguna de las ocho tiene una incidencia publicada. La mayoría son menores y ni te enteras.
- Unos 8,7 días al mes, alguna tiene una incidencia que la propia empresa marca como grave. Ahí es cuando tu equipo dice «no va».
No es una predicción exacta: los fallos no siempre son independientes (si cae AWS o Cloudflare, caen varias a la vez) y cada empresa decide qué llama grave. Pero sirve para dimensionar: que algo falle no es una excepción, es el día a día.
Y en España
El 20 de mayo de 2025, un fallo en la red fija de Telefónica dejó sin 112 a varias comunidades, que tuvieron que habilitar números alternativos. La compañía lo atribuyó a «trabajos de actualización de la red»: otra vez un cambio planificado. Las fuentes no coinciden en la hora a la que se restableció, así que no lo incluimos en el ranking.
Qué hacer el lunes: el plan de una pyme para cuando se cae algo
- Haz la lista de tus herramientas críticas, las que paran la empresa si fallan: correo, facturación, TPV o tienda, telefonía. Para cada una, apunta su página de estado (casi todas tienen una) y suscríbete a los avisos por correo o RSS.
- Decide el plan B de cada una antes de necesitarlo. Correo: una lista de teléfonos de clientes y proveedores clave fuera del propio correo. Facturación: poder emitir una factura desde otro sitio. Tienda: un mensaje preparado para redes.
- No metas todos los huevos en la misma cesta para lo vital. Si el correo, los documentos y las reuniones dependen del mismo proveedor, una caída como la de esta semana te deja sin las tres a la vez.
- Ten copias que no dependan del proveedor. Una exportación periódica de los contactos, los documentos clave y la contabilidad. Atlassian tardó hasta dos semanas en devolver los datos a algunos clientes.
- Revisa qué dice tu contrato. Los acuerdos de nivel de servicio (SLA) de los grandes proveedores suelen compensar con crédito en la factura, no con lo que pierdes. Si una herramienta es crítica, mira el compromiso de disponibilidad antes de elegirla.
- Aplica la lección de los grandes en casa: si tú o tu proveedor informático cambiáis algo (una actualización, una configuración), hacedlo poco a poco, fuera de horas punta y con forma de volver atrás.
Si tu web es lo que no puede caer, en cómo dejar WordPress: web rápida y segura contamos cómo montarla para que aguante; y si estás pensando en meter agentes de IA que dependen de estos servicios, en agentes de IA para empresas explicamos cuándo compensa.
Limitaciones
- Diez caídas no son una muestra estadística. Son las más sonadas con informe oficial; la conclusión sobre los cambios es un patrón, no una proporción del total de caídas del mundo.
- La clasificación del disparador es nuestra, a partir del texto de cada informe. Están enlazados en
datos/caidas.jsonpara que cualquiera la revise. - La caída de Microsoft 365 sigue abierta y su causa no está confirmada. Las 26 horas van desde que se dispararon los avisos hasta la última actualización oficial consultada (13/11/2026, 20:02 UTC): no son la duración final.
- Las páginas de estado miden lo que cada empresa decide publicar, no la disponibilidad real. La gravedad la marca cada empresa con su criterio, y algunas (Zoom, HubSpot, Cloudflare, Twilio) no marcan casi nada como grave.
- La API solo devuelve los últimos 25 o 50 incidentes, así que cada servicio se mide en una ventana distinta; los más transparentes, en ventanas más cortas.
- El cálculo de la pila de ocho herramientas supone fallos independientes, y no lo son del todo.
- Microsoft 365 y Google Workspace no publican su historial con esta API, así que no están en la medición de páginas de estado.
Cómo repetirlo
python3 recolectar.py                          # descarga los incidentes de las páginas de estado
uv run --with matplotlib python analizar.py    # resumen, tablas y gráficos
Las fuentes de cada gran caída están en datos/caidas.json y los resultados en resultados/.
¿Quieres saber qué pasaría en tu empresa si mañana cae tu proveedor principal, y qué plan B te sale a cuenta? Encárganos el experimento.